회사 업무에 AI를 들이는 곳은 늘었지만, "검수는 사람이 한다"는 원칙만 있고 무엇을 얼마나 볼지, 그 일을 누가 맡을지는 정해두지 않은 경우가 많습니다. 확신도 수치 하나만 보고 넘어가는 습관은 대개 여기서 시작됩니다. 이 글은 그 빈 자리를 채우는 기준을 다룹니다.
확신도 수치는 검수가 아니다
AI가 결과와 함께 내놓는 확신도(%)는 모델이 자기 판단에 얼마나 확신하는지를 보여주는 값입니다. 결과가 실제로 맞다는 보증은 아닙니다.
실제 판단은 그다음 단계, 원본과의 직접 대조에서 이뤄집니다. 도면 인식이라면 원본 도면과, 문서 추출이라면 원본 문서와 결과를 나란히 놓고 봐야 확신도가 놓친 부분이 드러납니다.
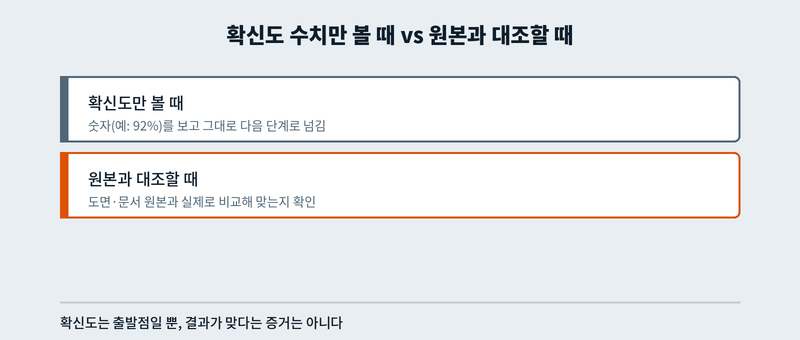
확신도가 높다는 이유로 대조를 생략하면, 검수는 형식만 남고 실질은 사라집니다.
실제로 이런 일을 본 적이 있습니다. OCR로 문서를 자동 인식해 데이터를 불러오도록 해두고, 오인식된 값을 검증 없이 그대로 넣은 경우였습니다. 잘못 들어간 값 때문에 내부 데이터끼리 서로 맞지 않게 되었고, 어디가 틀렸는지 찾아 바로잡는 동안 큰 혼란을 겪었습니다. 인식이 잘 된다는 믿음이 대조 단계를 없앤 셈입니다.
검수가 무너지는 두 가지 방식
실제로 자주 나타나는 검수 실패는 두 갈래로 나뉩니다.
- 과신형: 확신도가 높으니 됐다고 판단해 그대로 통과시키는 경우. 대조 단계 자체가 생략됩니다.
- 형식적 훑기형: 대조는 하지만, 시간에 쫓겨 겉만 훑고 넘어가는 경우. 절차는 지켰지만 실질은 과신형과 다르지 않습니다.
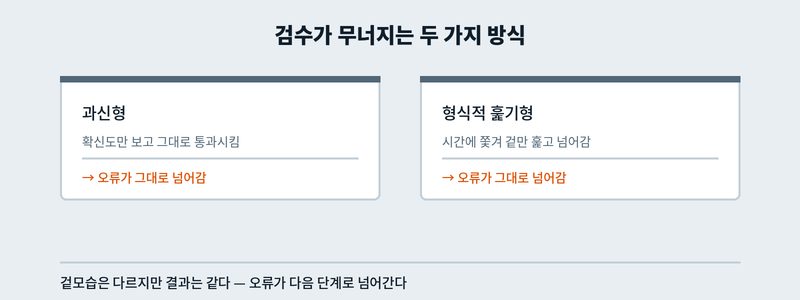
겉으로는 하나는 게으르고 하나는 성실해 보이지만, 결과 앞에서는 구분이 없습니다. 두 경우 모두 오류가 그대로 다음 단계로 넘어갑니다.
정확도 %가 검수량을 정하지 않는다
"정확도 95%"라는 숫자는 전체 평균입니다. 어떤 개별 건이 그 5%에 속하는지는 알려주지 않습니다.
100건을 처리했다고 가정하겠습니다.
| 구분 | 건수 | 어느 건인지 알 수 있는가 |
|---|---|---|
| 맞은 건 | 95건 | 모름 (섞여 있음) |
| 틀린 건 | 5건 | 모름 (섞여 있음) |
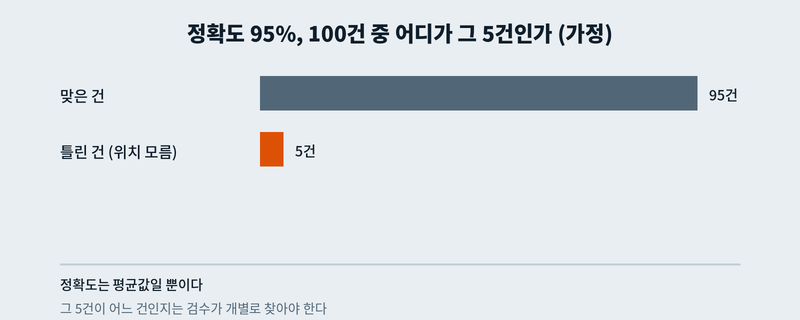
정확도가 높을수록 검수를 줄여도 된다는 통념은 이 지점에서 어긋납니다. 정확도는 검수량을 정해주는 숫자가 아니라, 검수 대상을 좁히는 데만 쓸 수 있는 숫자입니다. 100건 중 5건이 어디 있는지 모르는 이상, 검수는 표본을 어떻게 뽑을지의 문제로 남습니다.
전수를 볼지 일부만 볼지는 그 결과가 다음에 어디로 쓰이는지, 틀렸을 때 되돌리는 비용이 얼마인지에 따라 회사마다 달라질 수밖에 없어 일반화하기 어렵습니다.
검수 실패는 개인이 아니라 배정 문제다
앞서 본 두 실패 유형은 담당자의 역량 문제로 보이기 쉽습니다. 하지만 담당자가 정해져 있지 않거나 대조에 쓸 시간이 배정돼 있지 않다면, 역량과 무관하게 같은 결과가 나옵니다.
검수가 작동하려면 최소한 세 가지가 정해져 있어야 합니다.
- 누가 보는가
- 무엇과 대조하는가
- 얼마의 시간을 쓰는가
이 셋이 비어 있는 채로 "검수는 하고 있다"고 말하는 경우가 많습니다. 검수 기준을 한 번 정하면 계속 쓸 수 있다는 생각도 다시 볼 필요가 있습니다. 처리하는 문서나 도면의 종류가 바뀌면 확신도가 놓치는 지점도 달라지므로, 기준은 주기적으로 다시 맞춰야 합니다.
표본을 고르는 세 가지 방식
전부 볼지 일부만 볼지는 회사마다 다르다고 했지만, 고르는 방식 자체는 크게 세 가지로 나뉩니다.
| 방식 | 어떻게 보는가 | 맞는 경우 |
|---|---|---|
| 전수 검수 | 모든 건을 원본과 대조 | 결과가 발주, 가공, 고객 제출로 바로 이어질 때. 도입 초기 |
| 무작위 표본 | 일정 비율을 무작위로 골라 대조 | 결과가 내부 참고용이고, 틀려도 다음 단계에서 걸러질 때 |
| 위험 기반 표본 | 확신도가 낮은 건, 금액이 큰 건, 처음 보는 양식을 우선 대조 | 건수가 많아 전수가 불가능하지만 놓치면 비용이 큰 건이 섞여 있을 때 |
어느 방식이든 처음 몇 주는 전수로 시작해 틀린 건이 어디에 몰리는지 확인한 뒤 줄여가는 편이 안전합니다. 틀린 건이 특정 양식이나 특정 항목에 몰린다면, 그 부분만 계속 전수로 두고 나머지를 표본으로 돌리면 됩니다.
검수 기준을 정할 때 먼저 확인하는 것
AI 결과를 업무에 들일 때 제가 먼저 확인하는 건 정확도 숫자가 아니라, 틀린 건이 나왔을 때 누가 언제 알아차리느냐입니다. 앞서 본 OCR 건처럼 틀린 값이 다음 단계로 넘어간 뒤에야 발견되면 되돌리는 비용이 가장 커지기 때문입니다.
검수 담당자와 대조 대상, 배정 시간이 적혀 있으면 표본 방식은 그 위에서 정하면 됩니다. 이 셋이 비어 있다면 어떤 방식을 골라도 같은 문제가 반복됩니다.
AI를 어떤 업무에 먼저 쓰는 것이 좋은지는 제조 현장에서 AI가 되는 일과 안 되는 일에, 문서를 AI에 넣기 전에 확인할 것은 사내 문서를 AI에 넣기 전에 확인할 것에 정리했습니다. 검수 담당자에게 무엇을 요구할지, 즉 자동화 요구사항을 문서로 남기는 방법은 자동화를 맡길 때, "지금 하는 대로"는 요구사항이 아닙니다에서 이어집니다.
'업무자동화·AI 활용' 카테고리의 다른 글
| 업무 자동화로 아끼는 시간, 계산을 믿어도 되는가: 만들기 전에 해 볼 보정 계산 (0) | 2026.10.10 |
|---|---|
| 자동화를 맡길 때, "지금 하는 대로"는 요구사항이 아닙니다 (0) | 2026.09.29 |
| 엑셀의 한계는 엑셀에 있지 않습니다 (0) | 2026.09.19 |
| 자동화를 만든 사람이 퇴사하면 생기는 일 (0) | 2026.09.17 |
| 사내 문서를 AI에 넣기 전에 확인할 것 (0) | 2026.09.15 |